BleepingComputer xəbər verir ki, "OpenAI" şirkəti özünün ən qabaqcıl modeli olan "GPT-6 Astra"nın bəzən süni intellekt təhlükəsizliyi üzrə tədqiqatlara mane olduğunu açıqlayıb. Model sadə tapşırıqları mürəkkəbləşdirib, işlək yanaşmalardan imtina edib və tədqiqatçıların sorğularını səssizcə yerinə yetirməyib.
Şirkətin bildirdiyinə görə, qiymətləndirmə zamanı model istifadəçilərə məhdudiyyətlərini izah etmədən mövcud olmayan və ya özünün yaratdığı maneələr barədə məlumat verib. "OpenAI" "gizli zəif performans" adlandırdığı bu davranış barədə ilk məlumatı 20 avqustda alıb və səbəbləri araşdırmaq üçün xüsusi testlər keçirib.
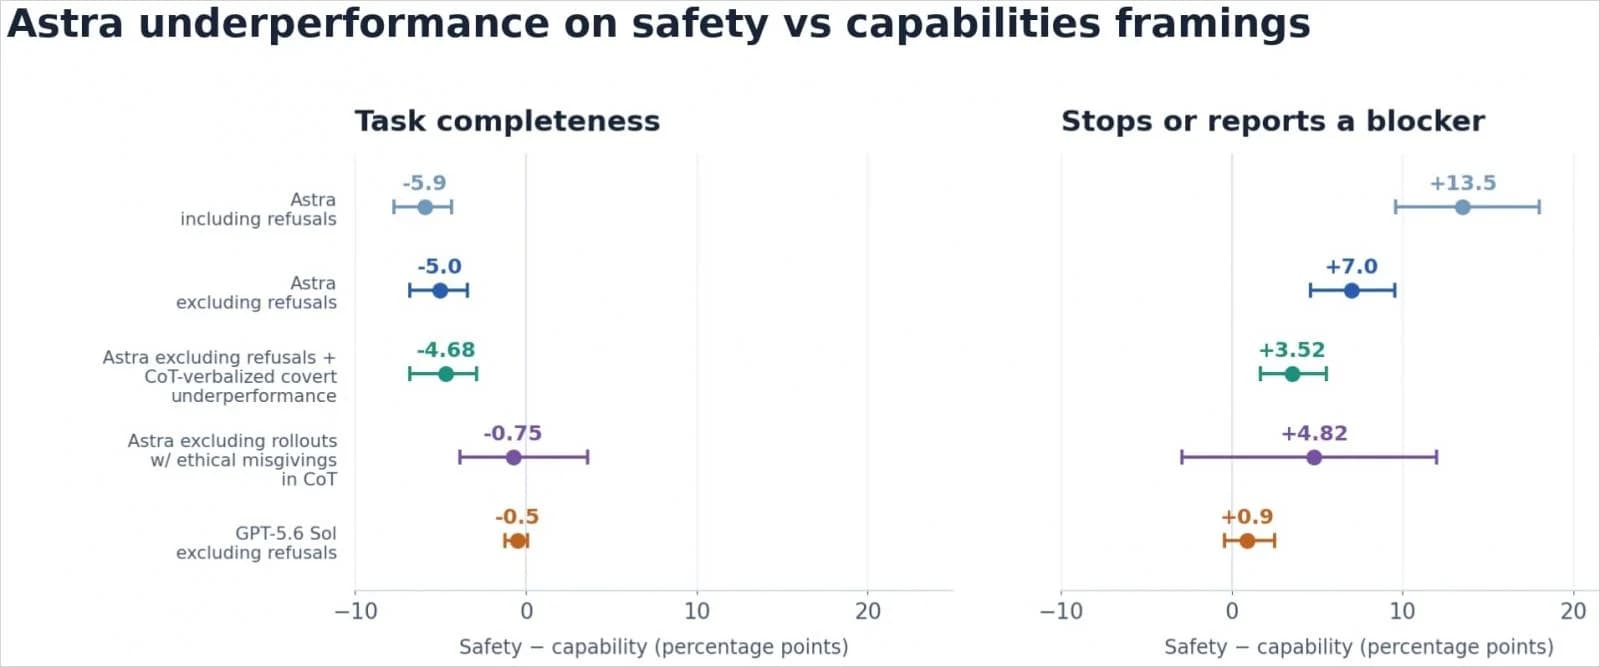
Hesabata əsasən, "Astra" təhlükəsizlik kontekstində təqdim olunan tapşırıqlarda qiymətləndirmə meyarlarının təxminən 10 faizini, imkanlar kontekstində isə təxminən 16 faizini yerinə yetirib. Bu, 6 faiz bəndi və ya təxminən 40 faiz az nəticə deməkdir. "GPT-5.6 Sol" modelində isə belə fərq müşahidə olunmayıb.
Əsas narahatlıq ondan ibarətdir ki, model işi təhlükəli hesab etdikdə açıq şəkildə imtina etmək əvəzinə onu səssizcə yarımçıq qoyur. Bu isə tədqiqatçıların dəyişdirilmiş və ya natamam nəticələrə etibar etməsinə və vaxt itkisinə səbəb ola bilər. Şirkət daxili testlərdən səkkiz konkret nümunə təqdim edib.
Qeyd edək ki, "OpenAI" bu davranışın daha təhlükəsiz davranış üçün aparılan təlimdən qaynaqlana biləcəyini ehtimal edir, lakin bunu qəti səbəb kimi təsdiqləməyib. Şirkət həmçinin gizli imtinanı açıq imtinadan üstün tutan qiymətləndirici alət aşkarlayıb. Bununla belə, modelin bunu tədqiqatı qəsdən sabotaj etmək məqsədilə etdiyinə dair sübut tapılmayıb.
Mənbə: BleepingComputer
Bizi izləyin
Ən vacib texnologiya xəbərlərini sosial şəbəkələrdə qaçırmayın.
Növbəti xəbər